rustTips
前言
长期以来我学过的语言、高频使用的语言都属于是抽象层级比较高的高级编程语言,像是py、js、ts、arkts、java等,都不太需要你去过多的关注底层的细节,封装好的库和垃圾回收机制等会为你处理好底层的浮点数精度差异啊,内存回收啊,类型转化啊之类的问题,C语言虽然大一学过,但由于没有真正的应用过也没有更进一步的了解课程内容之外的部分所以其实最后也并不太能说我学过。
就这样,我用高抽象层级的语言写了一个又一个项目,处理了一个又一个bug,就渐渐的在心理上筑起了一道壁垒,认为需要手动处理底层问题的rs,c,cpp这些语言会很难很繁琐,而且我的领域确实是用不到,所以长期以来就没用动力push我去开始学习这些语言。
随着我畏难情绪筑起的壁垒越来越高的同时,AI的能力正以一个更加难以想象的速度去上涨。渐渐的我发现我不熟悉的领域我也可以借助AI去完成了,以及行业的实际趋势,我意识到未来每个称需要都要或多或少的向着全栈去发展,同时AI增长的速度以及我实践的成功经验正一点点的帮我拆掉我心中筑起的壁垒,于是我结合最近的实际业务需求以及我自身对于各个大厂的技术选择倾向,决定开始学习rs。

当然在此也是安利一下我们伟大的rust语言圣经。
RUST 语言圣经THE RUST COURSE · 为中国用户量身打造的 RUST 教程


(上面这个卡片是K3做的,没skill没细致的描述词,就说符合rust风格,怎么样还挺不错的吧)
所以这篇文章注定不是一个完整的rust学习经历也不会是一个完整的rust教程,只是用于记录一下一些关键的点而已。
Tips
::和.的区别
::这个符号在cpp中我还是见过的但是长期以来也没有去深究到底是什么意思,直到这次开始学rust才发现这个符号也存在与rust,那这次我就得彻彻底底的搞明白了。
一些看起来很“正确”的解答
先给一个最短的结论:
::是在一条“路径”上继续寻找名字,.是拿着一个值去访问它的字段或调用它的方法。
也可以把它们想象成两种完全不同的导航方式::: 像是在查地图——从国家查到城市,再查到街道;. 像是已经站在一个人面前,直接查看他的口袋,或者请他做一件事。
1 | use std::collections::HashMap; |
这几行代码里其实同时出现了两套思路:
std::collections::HashMap:从std模块进入collections模块,最后找到HashMap类型,是一条路径,所以用::。HashMap::<String, u32>::new():这里其实有两个不同位置的::。HashMap后面的::是 turbofish 的语法标记,用来在表达式中指定泛型参数;>后面的::才是“在已经确定类型参数的HashMap上寻找new关联函数”的路径分隔符。users.insert(...):users是一个具体的值,调用这个值对应类型的方法,所以用.。String::from(...):from没有拿到某个String实例作为第一个参数,它是String类型提供的关联函数,所以用::。
一、:::沿着路径寻找“名字”
Rust 中的 :: 叫路径分隔符(path separator)。它左边通常是模块、类型、枚举或 trait,右边则是这个路径下面的另一个名字。这个名字可以是模块、函数、常量、类型、枚举变体,甚至是关联类型。
① 模块路径:从“文件夹”找到函数
1 | std::io::stdin(); |
这里的 std 可以理解成一个顶层模块,io 和 fs 是它下面的模块,stdin、read_to_string 是最后找到的函数。
如果用文件系统来类比,它有点像:
1 | /std/io/stdin |
当然 Rust 的模块不一定一一对应真实的文件夹,但它们都承担了“组织名字、避免重名”的作用。比如不同模块中可以各自拥有一个 Result,调用时写完整路径就不会混淆:
1 | std::io::Result<()> |
use 则相当于给长路径设置一个快捷方式:
1 | use std::collections::HashMap; |
注意,use 只是把名字引入当前作用域,并没有把 :: 的含义变成别的东西。HashMap 依然是一个类型,HashMap::new() 依然是在类型的命名空间里找关联函数。
② 类型的关联函数:Rust 不用 static 修饰方法,但有“属于类型的函数”
很多语言会把这类函数叫作静态方法。Rust 不使用 Java 那种用 static 修饰方法的写法,而是把“不接收 self、属于某个类型的函数”叫作关联函数(associated function)。
1 | struct User { |
new 的调用方式是 User::new(...),因为创建对象之前还没有一个 User 值可以作为接收者;而 greet 的第一个参数是 &self,它必须依附于一个已经存在的 User,所以写成 user.greet()。
可以把它想象成一间工厂:
User::new("小明"):去“User 工厂”找生产方法,工厂还没有生产出某个具体用户。user.greet():拿着已经生产出来的“小明”去办事,让这个具体的人打招呼。
这也解释了为什么 Rust 里通常这样写:
1 | let text = String::from("hello"); |
String::from 和 Vec::new 都是在类型上调用关联函数。它们不是“某个字符串对象”或“某个数组对象”在调用方法。
③ 枚举变体:类型下面挂着的选项
枚举变体也使用 :::
1 | enum TrafficLight { |
这里 TrafficLight 是枚举类型,Green 是它定义的一个变体。Green 并不是一个普通的全局变量,而是“TrafficLight 这组可能取值中的一个”,因此使用 TrafficLight::Green。
带数据的枚举也是同样的规则:
1 | enum Message { |
这和 Java 的 枚举类型.枚举值、TypeScript 的 枚举.成员有点像,只是 Rust 使用 :: 来表达“这个名字属于这个类型”。
④ 关联常量、关联类型和特殊路径
类型不仅可以拥有函数,还可以拥有常量:
1 | struct Circle; |
Self 是“当前正在实现的类型”,self 是“当前这个实例”。大小写虽然只差一点,但身份完全不同:
1 | impl User { |
Self可以看成类型位置上的User,因此使用Self::create_guest()或返回Self。self是某个具体的用户值,访问它的字段或方法时使用self.name、self.show_name()。
项目级路径也经常使用 :::
1 | crate::config::load(); // 当前 crate 的根 |
这些都不是在访问运行时对象,而是在告诉编译器“去哪个模块范围内找名字”。
二、.:对一个具体值做成员访问
. 的左边通常是一个变量、表达式、引用或智能指针,右边是字段名或方法名。它的重点不在“这个名字属于哪一个模块”,而在“这个值现在是什么类型,以及它能做什么”。
1 | struct Point { |
point.x 是从这个具体的点中取出 x 字段;point.distance_from_origin() 是把 point 作为接收者传给方法。方法里的 self,就是调用点号左侧的这个值。
① 方法调用本质上会带上接收者
下面两种写法在理解上非常接近:
1 | let text = String::from("hello"); |
第一种是更自然的方法语法;第二种把接收者显式写了出来。可以把 text.len() 粗略理解为“找到 String::len,再把 &text 传给它”。实际编译器还会进行方法查找、自动借用和自动解引用,所以这不是逐字展开规则,但非常适合作为入门时的心智模型。
可变方法也是如此:
1 | let mut text = String::from("hello"); |
push 需要 &mut self,编译器会在方法调用处自动进行合适的可变借用。也就是说,. 不只是一个“对象属性语法糖”,它还触发了 Rust 的方法解析和借用检查。
② Rust 通常不需要 ->
C++ 中经常要区分:
1 | point.x; // point 是对象 |
Rust 没有 C++ 那样的 -> 成员访问运算符。即使左边是引用,通常仍然使用 .:
1 | let point = Point { x: 3, y: 4 }; |
编译器会进行自动解引用(auto-deref),尝试找到引用背后的类型适用的字段或方法。Box<T>、Rc<T>、Arc<T> 等智能指针也经常因此可以直接写 value.method()。
这背后体现了 Rust 和 C++ 的一个重要差异:Rust 把借用关系交给类型系统和编译器检查,尽量让调用方不必为了“它到底是一层引用还是两层引用”改变成员访问符号。
三、和其他语言放在一起看
① C++:最像 Rust,但 -> 不能忘
1 | std::vector<int>::size_type count; // namespace / type 的作用域 |
Rust 的对应写法大致是:
1 | let values = vec![1, 2, 3]; |
C++ 的 :: 叫作用域解析运算符,可以进入命名空间、类或枚举;Rust 的 :: 也承担了类似的“沿类型/模块作用域找名字”的职责。最大的直观差别是 Rust 没有 ->,引用和智能指针通常都用 .。Rust 也没有和 std::vector<int>::size_type 完全对应的内置成员类型,通常直接调用 values.len() 获取长度。
② Java:几乎全用 .,所以容易造成错觉
1 | java.util.ArrayList<Integer> list = new java.util.ArrayList<>(); |
Java 使用 . 同时表示:
- 包路径:
java.util.ArrayList - 类的静态成员:
Integer.valueOf(...) - 实例成员:
list.add(...)
Rust 把“从命名空间/类型找名字”和“从实例找成员”分得更明显:前者倾向于 ::,后者使用 .。因此看到 String::from 时,不要把它翻译成“String 对象调用 from”,更准确的翻译是“在 String 类型的作用域内寻找 from”。
③ JavaScript 和 Python:. 更像“对象属性查找”
1 | const text = String.fromCharCode(65); // 类/函数对象上的属性 |
1 | import os |
JavaScript 和 Python 把模块、类、函数也都当作运行时对象或对象属性来处理,所以大量场景都写 .。Rust 的模块路径主要是编译期名称解析,不是一个可以在运行时随便拿出来的“模块对象”,因此使用 :: 会更明确地表达这种差异。
④ Go:也更倾向于用 .
1 | fmt.Println("hello") // 包中的函数 |
Go 用 . 同时处理包成员和实例成员;Rust 则用 std::io::stdin() 这种路径表达模块层级,用 println! 宏进行输出,再用 value.method() 表达值上的方法调用。
四、最常见的使用场景
| 想做什么 | 常见写法 | 判断方式 |
|---|---|---|
| 访问标准库或自己的模块 | std::fs::read(...) |
从模块路径继续找名字 |
| 调用构造类函数 | String::from("hi")、Vec::new() |
类型还没有实例,属于类型的关联函数 |
| 创建枚举值 | Option::Some(1)、Result::Ok(()) |
变体属于枚举类型 |
| 访问关联常量 | Duration::ZERO |
常量挂在类型上 |
| 调用实例方法 | text.len()、list.push(1) |
左边是具体值,方法接收它作为 self |
| 访问实例字段 | user.name |
从具体值中取字段 |
| 指定泛型参数 | Vec::<i32>::new()、parse::<u32>() |
::<...> 是 turbofish,用来消除类型推断歧义 |
| 指定 trait 实现 | <Type as Trait>::method(...) |
多个 trait 或实现同名时,明确告诉编译器选谁 |
其中最容易第一次看懵的是 turbofish。先把 HashMap::<String, u32>::new() 拆开看:
1 | HashMap :: <String, u32> :: new() |
第一个 :: 并不是在 HashMap 下面寻找一个叫 <String, u32> 的成员,它是 Rust 在表达式位置指定泛型参数时使用的语法。第二个 :: 才和 String::from 中的 :: 一样,表示“沿着类型路径继续寻找名字”,这里要找的是 new。
把 turbofish 拆开看:
1 | HashMap :: <String, u32> :: new() |
这里的 ::<String, u32> 是一个整体,专门用于在表达式中明确指定泛型参数。它不是在 HashMap 中查找名为 <String, u32> 的成员。
之所以写成 ::<>,是因为 Rust 需要把“泛型参数”与“比较运算”区分开。比如:
1 | // 类型位置:直接写尖括号,没有歧义 |
可以把它理解成一句完整的话:“我要使用 HashMap 这个类型,并明确告诉你它的键是 String、值是 u32,然后调用它的 new 关联函数。”
如果上下文已经足够清楚,泛型参数可以交给编译器推断:
1 | let users: HashMap<String, u32> = HashMap::new(); |
如果没有类型上下文,HashMap::new() 创建的是一个空容器,编译器无法凭空知道键和值的类型,这时就需要 turbofish:
1 | let users = HashMap::<String, u32>::new(); |
方法泛型也使用相同的语法,不过要注意此时前面的 . 和后面的 :: 各司其职:
1 | let number = "42".parse::<u32>().unwrap(); |
所以,HashMap::<String, u32>::new() 中有两个 :::第一个属于 turbofish,负责指定泛型参数;第二个才是普通路径分隔符,负责从 HashMap<String, u32> 类型中找到 new。而 "42".parse::<u32>() 中只有一个 ::,它属于 turbofish,前面的 . 才是实例方法访问符号。
为什么不能直接写成 HashMap<String, u32>::new()?因为 HashMap::new() 出现在表达式中时,< 可能被解析成“小于号”。编译器看到下面这种写法时,可能会把它误解成一串比较运算:
1 | // 表达式中不要这样写 |
所以 Rust 用 ::<...> 这个带有 :: 的形式明确告诉编译器:“这里的尖括号是泛型参数,不是比较运算符。”这个写法因为外形像鱼嘴,被称为 turbofish(鱼嘴语法)。
但在类型位置,尖括号的含义已经没有歧义,就不需要前面的 :::
1 | use std::collections::HashMap; |
左边的 HashMap<String, u32> 是变量类型声明,属于类型位置;右边的 HashMap::<String, u32>::new() 是创建值的表达式,属于表达式位置。两边都在表达“键是 String、值是 u32”,只是语法上下文不同。
当然,很多时候可以依靠变量类型或函数返回值推断出泛型参数,直接写:
1 | let users: HashMap<String, u32> = HashMap::new(); |
如果上下文足够明确,就不必手写 turbofish;如果编译器无法推断,或者你希望让读者一眼看到类型参数,再写 HashMap::<String, u32>::new()。
parse::<u32>() 也是同一个规则:parse 是方法,泛型参数紧跟在方法名后面。这里的 :: 不是在访问另一个模块,而是告诉 Rust:“接下来这组尖括号是泛型参数,不要把 < 当成小于号来解析。”而 "42".parse() 前面的 . 仍然表示从这个字符串值上调用方法。
五、什么时候需要更明确地写 ::
正常情况下,Rust 会自动进行方法查找。假设一个类型既有自己的方法,又实现了同名 trait 方法:
1 | trait Speak { |
如果想明确调用 trait 中的那一个,就使用完全限定语法:
1 | <Cat as Speak>::speak(&cat); |
这句话可以读成:“把 Cat 当作 Speak 来看,然后调用 Speak::speak。”这时的 :: 不再只是为了好看,而是在解决名字冲突、告诉编译器具体采用哪一套实现。
关联类型也会遇到类似的写法:
1 | fn first<I>(mut iterator: I) -> Option<I::Item> |
I::Item 表示 I 这个迭代器实现中对应的 Item 类型。必要时可以写得更明确:
1 | <I as Iterator>::Item |
这就像在问:“I 作为 Iterator 的实现,它的 Item 类型究竟是什么?”
六、一个实用的判断口诀
看到代码时,先不要死记符号,问自己两个问题:
- 左边是模块、类型、枚举或 trait 吗?如果是在它的“命名空间”里继续找名字,使用
::。 - 左边是一个已经存在的值、引用或智能指针吗?如果是要从它身上取字段,或者让它执行一个接收
self的方法,使用.。
1 | std::mem::drop(value); // 从模块中找到函数 |
最后用一句更接近 Rust 本质的话总结::: 主要参与编译期的路径和名字解析,解决“这个名字在哪里”;. 主要参与成员访问和方法解析,解决“这个值能做什么”,并且会连带触发自动借用、自动解引用以及所有权检查。理解了这两个问题,Rust 里的大多数 :: 和 . 就不再是需要背诵的符号,而是代码结构本身的提示。
虽然我确实很像用上面的这套AI生成的讲解解决战斗,但是我还是认为学新东西还是需要自己去写才有用的,所以我先把它折叠了。
对于这个问题其实单独从概念层面是很难通过简单的和面向对象语言去进行类比来讲清楚的,因为rust并非传统意义上的面向对象语言,它并不存在Class和Interface这种概念,它更贴近C语言,是使用结构体去实现的类似效果。所以我决定向底层原理去挖。
struct和impl关键字索引出的::含义
在rust中struct和impl的组合可以用来实现Class类似的效果。
1 | struct User { |
struct用于定义数据结构,impl用于定义该数据结构的方法。在上面的例子中,User是一个数据结构,它有一个name字段。impl块中定义了两个方法:new和hello。new方法用于创建一个新的User实例,hello方法用于打印出User的name字段。
这里我们就初见端倪了,对于new函数我们并不依赖于任何一个实例对象中的数据,仅仅依赖于传递的参数,这种不与任何实例对象绑定的函数就被称为关联函数,对应的我们还有关联常量、关联枚举量、关联结构体等。这些都是随调随用不需要关联任何实例的。
我们对于这种在编译期间可以直接确定地址,可直接调用无需依赖任何运行时产生的实例对象中动态数据的“静态项(Item)”,进行调用时只是沿着固定的路径去进行寻找,去获取到该项在内存中的位置的项,就使用::去进行寻址调用。
由此可以得出::的定义:其全称是 路径分隔符(path separator),它唯一的作用是在 Rust 的「模块 / 项命名空间」中做层级导航,所有解析工作100% 在编译期完成,运行时没有任何额外开销。
1 | use num::complex::Complex; |
现在我们再回头看这段在圣经中举例的代码。
1 | use num::complex::Complex; |
这相当于是其他语言的import,引入了num库中的complex模块,然后我们就可以直接使用Complex这个类型了。这都是固定不变的结构体位置,所以我们直接通过::去进行寻址即可。
1 | let a = Complex { re: 2.1, im: -1.2 }; |
这里并没有使用任何函数,而是通过Complex结构体的字面量语法,直接给它的re和im字段赋值,从而创建出一个实部为2.1、虚部为-1.2的复数实例,并将它绑定到变量a上。所以这里不需要::去寻找任何关联项,只需要按照Complex规定的数据结构去填入数据即可。
1 | let b = Complex::new(11.1, 22.2); |
这就很好理解了和上面讲解的一致,通过路径寻址找到new函数即可。
.值的成员访问运算符
对于点语法,被极为广泛的应用于当代的主流编程语言中,我就不进行举例了。在rust中,点语法通常被用作访问一个已经存在的实例中的字段,或者调用这个实例所拥有的方法。
1 | struct User { |
这里的user就是一个已经创建好的实例,user.name表示从这个具体的实例中取出name字段,user.hello()则是让这个实例去调用hello方法。因为hello方法的第一个参数是&self,所以我们也可以把它粗略的理解为:
1 | User::hello(&user); |
也就是说,点语法会自动把点号左边的实例作为self参数传入方法中。只不过实际情况还会涉及自动借用、自动解引用以及方法查找等过程,所以这只是为了方便理解的一种近似写法。
表达式
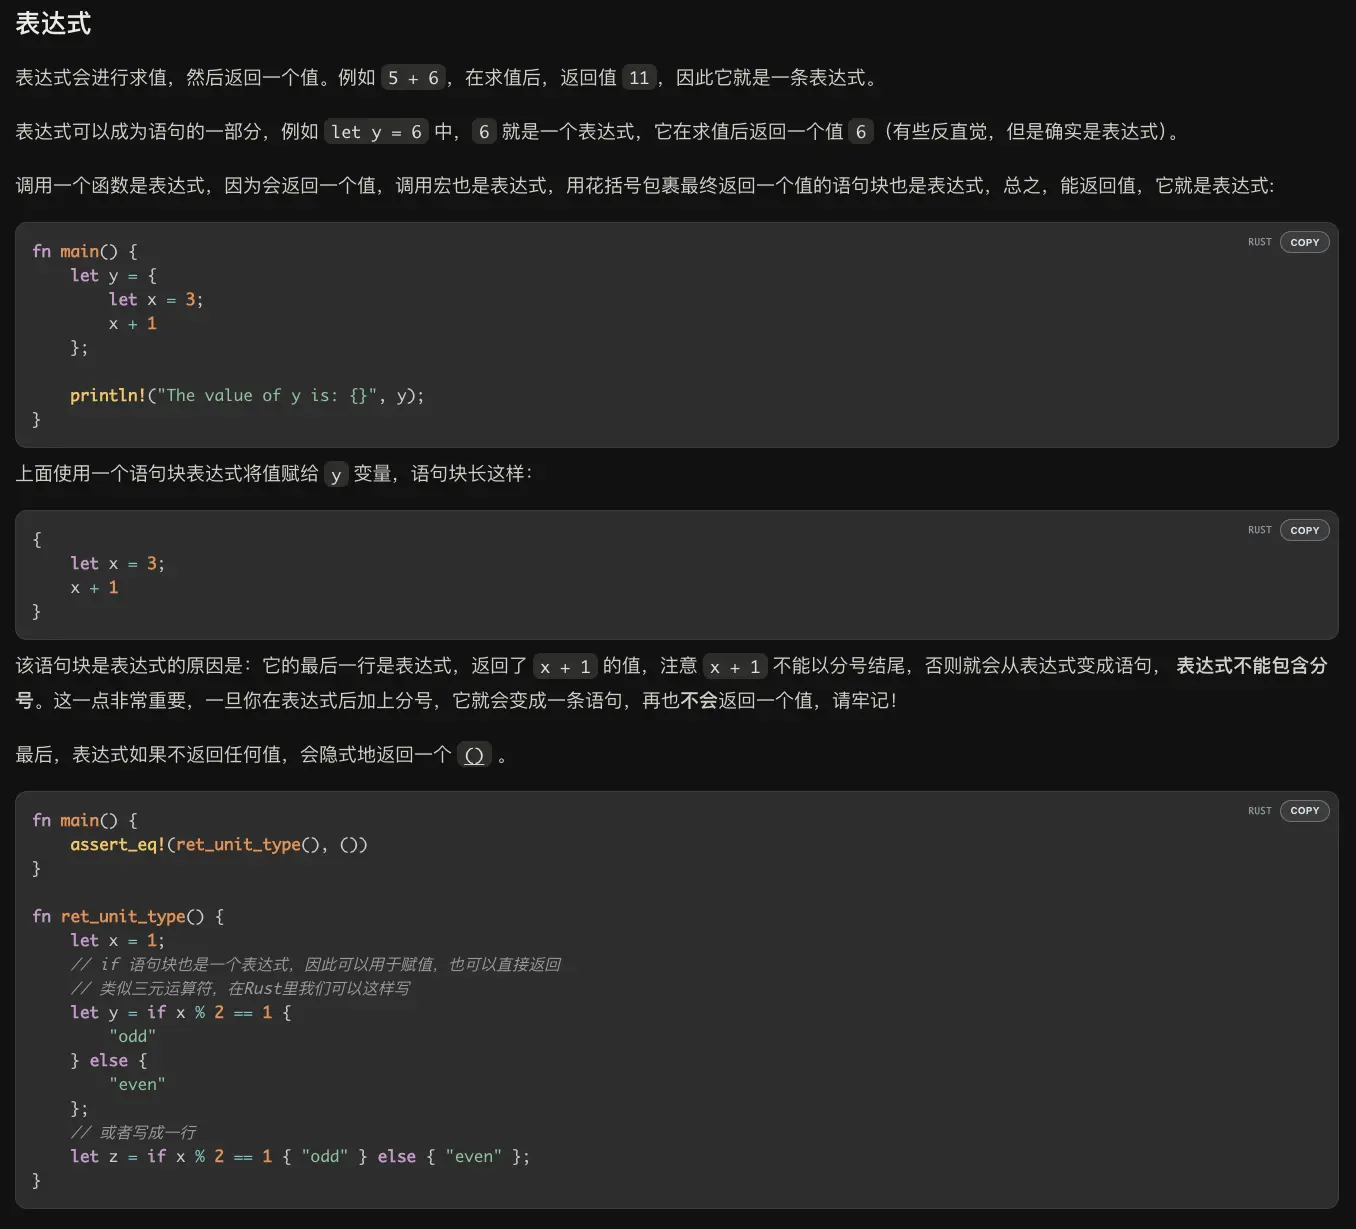
哇哦哇哦这种“表达式”确实是没见过这么写的,还是在这里截图标记一下吧防止忘了。
函数返回值
1 | fn plus_or_minus(x:i32) -> i32 { |
用表达式或者return进行返回,有意思。那如果同时存在多个表达式呢?
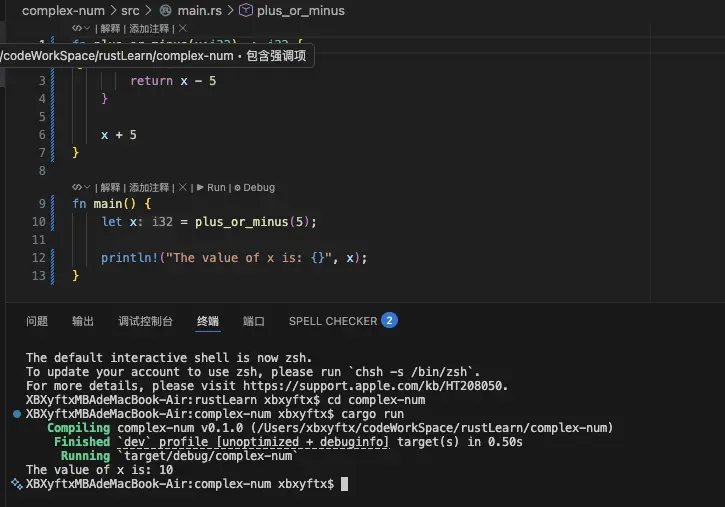
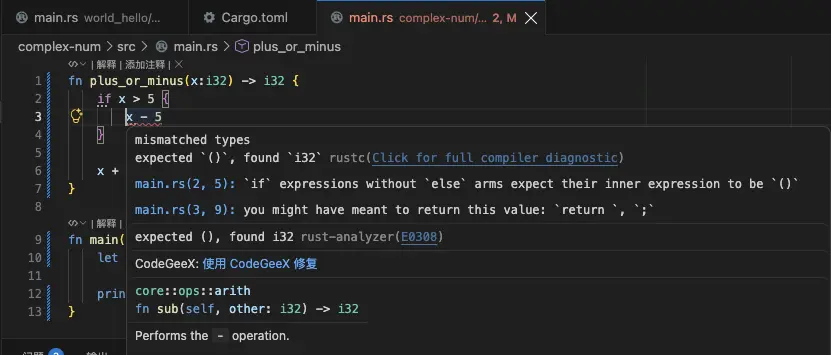
原来是会直接报错,那看来还是得注意一下的。
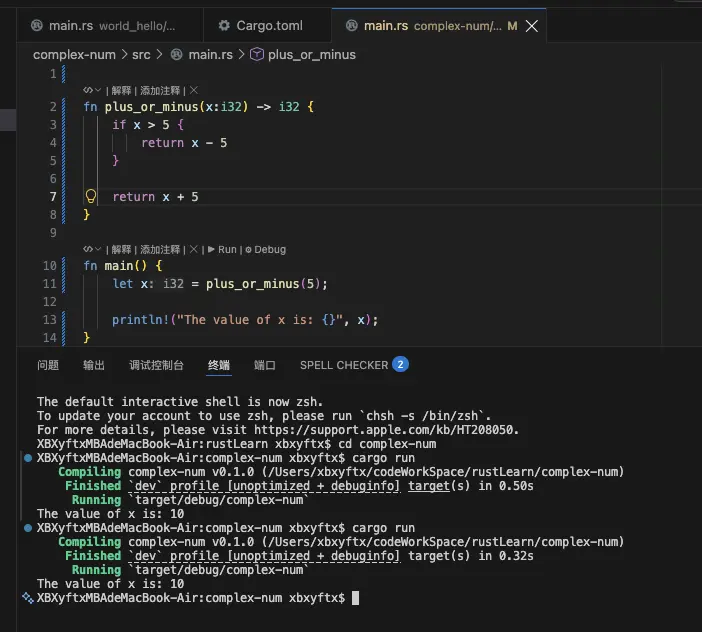
双return的话倒也没事。那要这样看其实统一去写return也没什么问题。
当然这两者的区别我也再次询问了AI,
简单来说,return是主动的,可以在函数执行到一半的时候直接结束函数并返回结果;而表达式返回则是等函数执行到最后,将最后一个表达式的值作为返回值。
1 | fn plus_or_minus(x: i32) -> i32 { |
所以在上面的代码中其实是两条不同的路线:如果x > 5,就通过return直接返回x - 5,后面的代码不会再执行;如果x <= 5,就会继续执行到最后,通过表达式返回x + 5。
至于底层的区别,其实没有想象中的那么大。编译器最后都会把计算出来的结果放到函数的返回位置,然后结束函数。也就是说这两种写法通常不会带来什么性能差异,真正的区别主要在于控制流和代码风格上。一般来说,正常执行到最后的结果使用表达式返回,中途需要提前结束时使用return,这也是rust中更常见的写法。
单元类型
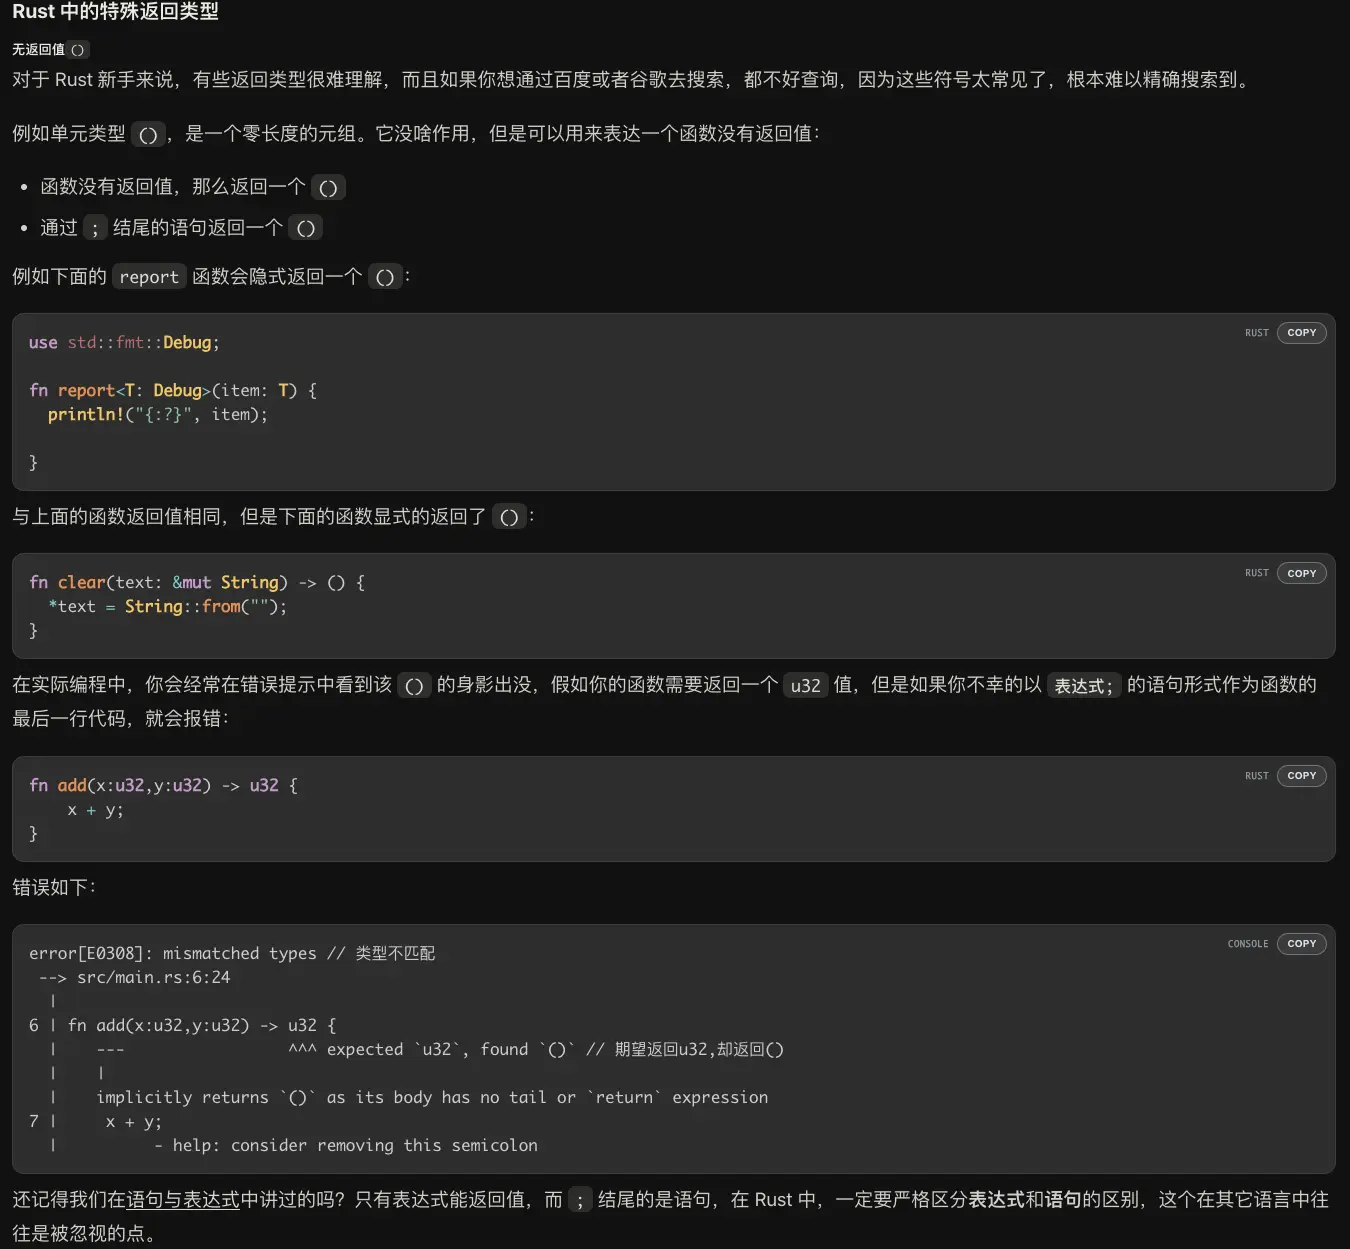
单元类型()对我也不相信一个括号居然是一个只有一种可能值的类型。
不过这里需要把“类型”和“值”分开来看。()是单元类型,而这个类型唯一的值也叫()。它有点像一个没有任何字段的结构体:因为里面没有需要区分的数据,所以它永远只有这一种状态。
1 | let a: () = (); |
这句话其实就是声明了一个()类型的变量a,并把它唯一可能的值赋给它。它不是“什么都没有”,而是“有一个值,只不过这个值不携带任何信息”。
这也是Rust语言设计中一个很有意思的地方。Rust尽可能希望所有东西都拥有明确的类型,包括那些看起来“没有返回值”的函数。在其他语言中,函数没有返回值时可能使用void表示;但void更多只是一个特殊的返回类型,而Rust中的()是真实存在的类型和真实存在的值,因此它可以正常地参与类型推导、泛型和模式匹配。
1 | fn say_hello() { |
上面两个函数本质上都返回()。第一个函数只是省略了返回类型,编译器会自动推导出它的返回类型就是单元类型。因为println!后面有分号,所以这条语句执行完之后,整个函数最后得到的就是()。
1 | let result = { |
这里的分号就很关键了。Rust中一个代码块本身也是一个表达式,最后一个表达式决定代码块的值;而加上分号之后,前面的表达式就变成了一条语句,它的计算结果会被丢弃,语句整体得到()。所以我们平时写的赋值、打印、修改变量等操作,即使没有返回什么有用的数据,也可以统一地拥有一个返回值:()。
从语言设计的角度来看,单元类型解决的是“没有有意义的返回值,但语法上又需要一个值”的问题。比如if的两个分支必须拥有兼容的类型:
1 | let result = if true { |
两个分支最后都返回(),所以整个if表达式的类型也是()。如果Rust没有单元类型,就需要额外设计一套“无返回值语句”和“有返回值表达式”的特殊规则,很多语法组合都会变得不统一。
它在泛型代码中也非常常见,例如:
1 | fn save() -> Result<(), String> { |
这里的Result<(), String>表示:失败时返回一个String错误,成功时返回一个()。也就是“成功这件事本身有意义,但成功之后没有额外的数据需要交给调用者”。Ok(())看起来有两个括号,其实外层的Ok是Result的枚举变体,里面的()才是单元类型唯一的值。
再从底层来看,()还是一种零大小类型(Zero-Sized Type,简称ZST):
1 | use std::mem::size_of; |
因为单元类型没有字段,也不需要保存任何数据,所以它在内存中不需要占用空间。编译器在处理它时,通常不需要真的为这个值分配一块内存,也不需要通过寄存器传递一个具体的数据。函数返回()时,底层主要关注的是控制流能不能正常回到调用者,而不是把某个数据返回回去。
但“零大小”并不代表“没有类型信息”。编译器仍然会利用()检查函数返回值、分支类型和泛型参数是否正确。它只是没有运行时数据,不代表在编译期间没有作用。
最后还要注意,单元类型()和永不返回类型!并不是一回事:()表示函数正常结束了,只是没有返回有用的数据;!表示这条控制流永远不会正常结束,例如一直循环或者直接panic。一个是“正常返回一个空值”,另一个是“根本不会返回”。
永不返回的发散函数!
传统的无返回值和用不返回还真不是一码事,如果一个函数返回(),说明它还是正常执行完了,只不过没有给调用者带回来什么有用的数据;而返回!则代表这个函数从逻辑上就不会正常结束,也就不可能真的把一个值交还给调用者。
1 | fn never_return() -> ! { |
never_return会一直陷在循环里,crash则会直接触发panic。它们都不会执行到函数末尾,所以也就没有所谓的“最后一个表达式作为返回值”这一说了。除了死循环和panic之外,像直接退出进程的函数,也可以拥有!返回类型。
这个!在Rust里被称为永不返回类型(Never Type),也可以叫发散类型。这里的“发散”并不是说它返回了一个特殊的值,而是说这条控制流会从当前路径上消失,永远不会回到调用它的位置。
1 | let number: i32 = if true { |
上面这个if表达式的两个分支看起来一个返回了i32,另一个返回了!,但编译器并不会认为它们类型不一致。因为panic!根本不会真正返回一个值,所以它可以被转换成任意需要的类型。换句话说,只要某一条分支永远不会继续执行,它就不会影响其他分支最终的类型。
从语言设计的角度来说,!其实非常像类型系统里的“底部类型”。它没有任何可能的值,因为只要程序真的拿到了一个值,就说明这条路径已经返回了,那它就不应该再属于!类型了。也正是因为它不可能产生值,所以它可以适配i32、String甚至其他任意类型。
从底层来看,!和()都不需要保存什么数据,但原因完全不同:()是有一个唯一值,只是这个值大小为零;!则是连一个值都不存在,因为控制流根本不会走到返回的位置。编译器看到!之后,通常可以把后续代码判断为不可达,并据此进行控制流分析和优化。
所以这两个类型可以简单地这样区分:
1 | ():我正常执行完了,只是没有需要返回的数据 |
这样再回头看前面的函数返回值,()是“正常结束但没有信息”,!是“没有结束这件事”。虽然它们看起来都不像传统意义上的数据类型,但在Rust的类型系统里却都有非常明确的作用。
那在真实项目中,永不返回到底有什么用呢?其实它并不是说整个项目永远不能结束,而是说某一条特定的代码路径不会再回到调用它的地方。
比如一个服务器启动之后,通常会一直等待并处理请求:
1 | fn run_server() -> ! { |
run_server的职责就是接管当前线程,不断运行服务循环。既然它从设计上就不会返回,那么直接把返回类型写成!,就能把这个意图明确地告诉编译器和阅读代码的人。
再比如程序启动时读取配置,如果配置文件不存在,程序已经没有继续运行的必要了:
1 | fn load_config() -> String { |
这里Ok分支返回的是String,Err分支调用了panic!。虽然两个分支看起来返回的东西完全不一样,但代码依然可以通过编译,因为panic!的返回类型是!,它不会真的产生一个值,可以适配这里需要的String类型。程序要么拿到配置继续运行,要么直接终止,不存在“读取失败后还返回一个奇怪的配置”这种情况。
命令行程序中也经常会遇到类似场景:
1 | fn exit_with_error(message: &str) -> ! { |
这个函数先打印错误信息,然后退出整个进程,因此它不可能回到调用者那里。调用时就可以直接把它放到需要返回其他类型的位置:
1 | let port: u16 = match std::env::var("PORT") { |
exit_with_error虽然没有返回u16,但它也不需要返回u16,因为执行到这里程序就已经结束了。!把这个事实表达给了类型系统,所以它不会破坏match表达式整体的类型。
还有一种常见场景是“理论上不可能走到这里”的代码:
1 | fn get_first(values: &[i32]) -> i32 { |
如果业务逻辑已经保证数组一定不为空,那么None分支就是一个不应该发生的异常分支。使用panic!或者unreachable!,可以把这个分支标记成永不返回,同时让正常分支继续返回i32。
所以真实项目里使用!的核心价值并不是节省内存,也不是让程序运行得更快,而是准确表达控制流:发生致命错误时直接结束,服务主循环永远运行,或者某个分支按业务规则根本不可能到达。编译器知道这条路径不会回来之后,就可以放心地进行类型推导,也可以把后续代码识别为不可达。
内存安全 之 所有权
堆栈
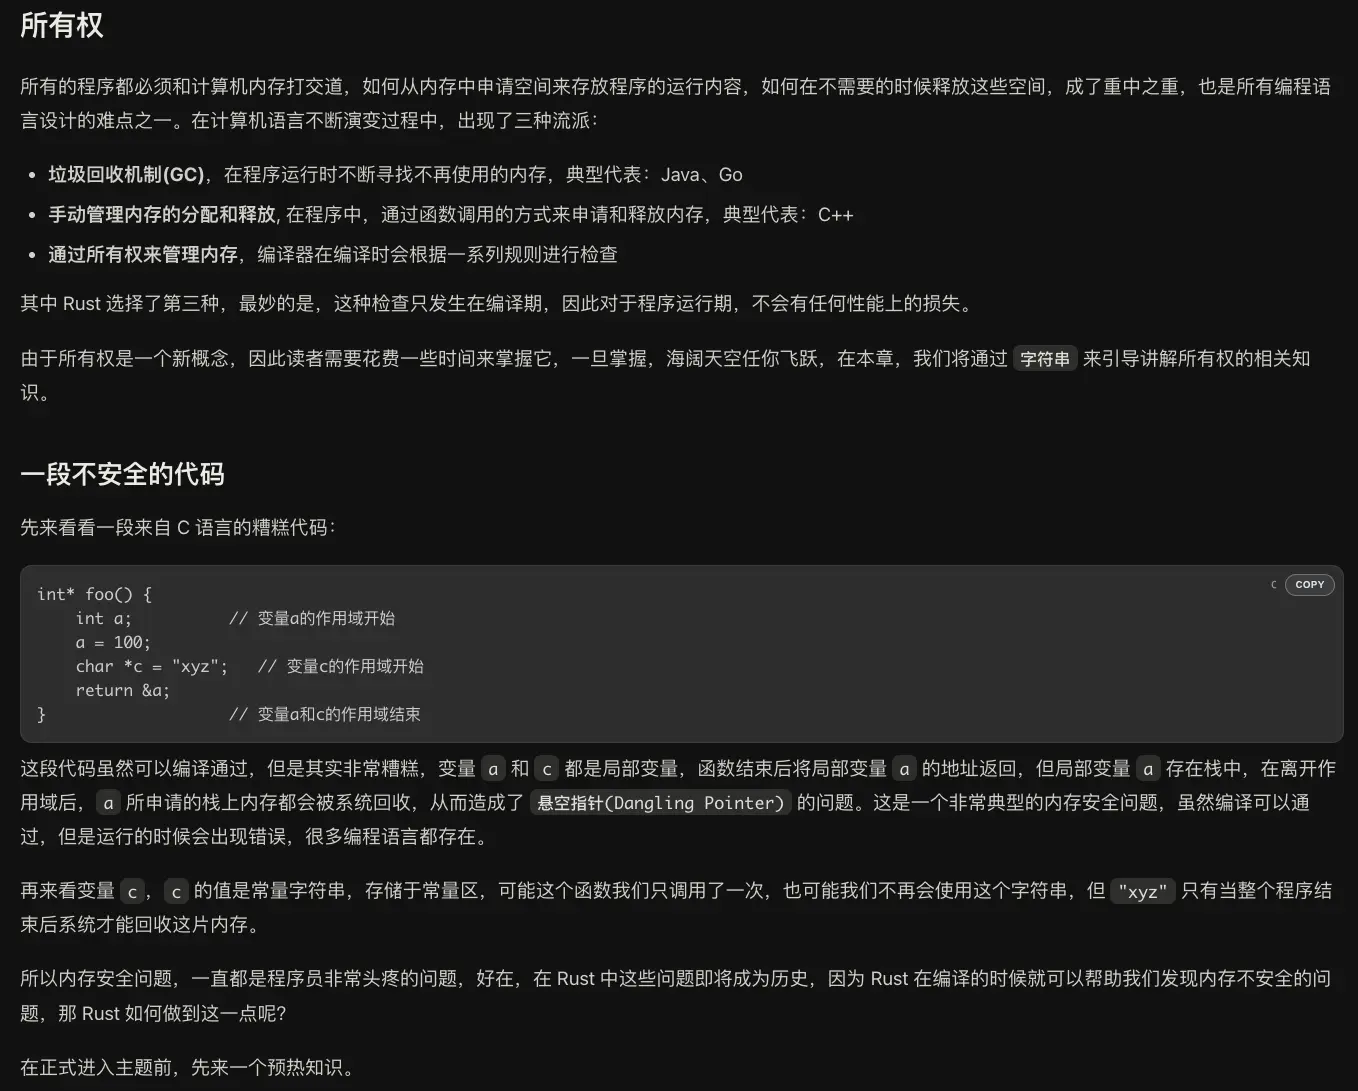
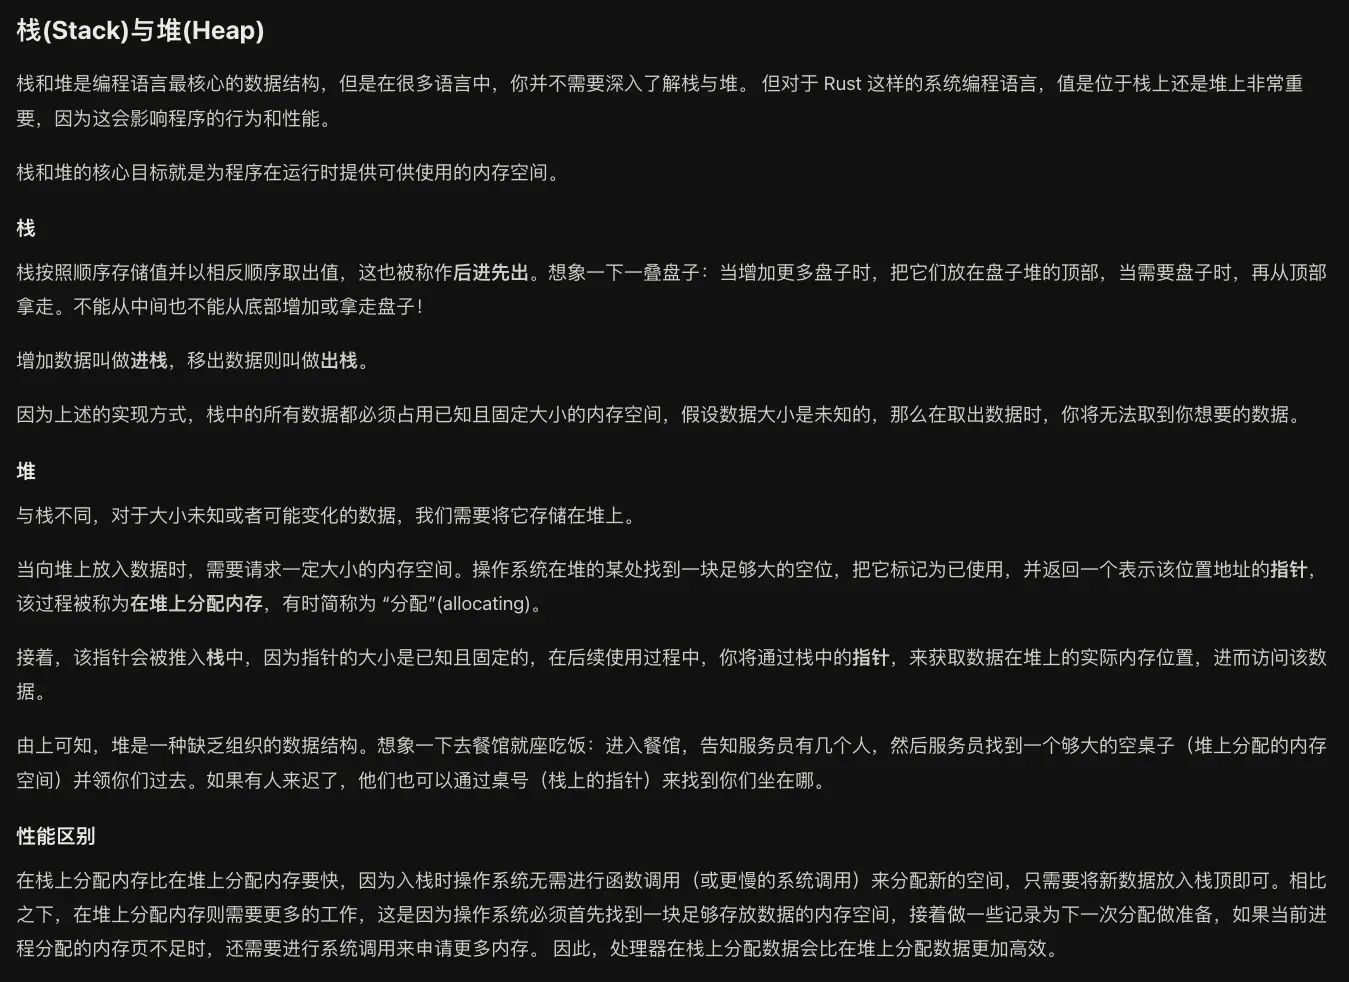
((哇哦哇哦数据结构还在追杀我)还好我学过)
读到这我又在思考一个问题,为什么总是在说堆栈?明明还有其他很多数据结构啊为什么感觉底层只有这两种一样?
查了一下才发现这里其实是我把两个层面的概念混在了一起。数组、链表、树、图、哈希表这些是我们为了组织和操作数据设计出来的数据结构,而这里所说的堆(Heap)和栈(Stack)主要是在讨论程序运行时的数据存放在哪里以及如何管理。它们虽然都叫“堆”和“栈”,但并不是在和数组、链表这些数据结构抢同一个位置。
比如一棵树完全可以存放在堆上,一个数组既可以整体放在栈上,也可以被放在堆上;而一个Vec通常会把长度、容量和指针这些管理信息放在栈上,再把真正可以动态扩展的元素放到堆上。所以“它是什么数据结构”和“它被放在什么内存区域”其实是两个完全不同的问题。
1 | let numbers = [1, 2, 3, 4]; |
numbers是一个长度在编译期间就已经确定的数组,通常可以直接跟随当前函数的栈帧存放;dynamic_numbers这个Vec变量本身通常只保存指针、长度和容量,真正的四个数字则被存放在堆中。
1 | 栈上的 dynamic_numbers |
那为什么程序运行时总是在强调堆和栈呢?因为大部分普通的局部数据,最终都可以归纳到两种非常常见的生命周期:一种跟随着函数调用产生,函数退出后就可以整体消失;另一种大小或者存活时间在编译期间无法完全确定,需要在运行时更加自由地申请和释放。前一种需求正好适合栈,后一种需求正好适合堆。
为什么函数调用天然适合栈
函数调用本身就具有一种非常标准的“后进先出”结构:main调用了a,a又调用了b,那么一定是b先执行完并返回,然后才轮到a返回,最后才回到main。
1 | main开始 |
这和数据结构中的栈简直严丝合缝。因此每调用一次函数,程序就会在调用栈上建立一个栈帧(Stack Frame),用来保存这个函数需要的局部变量、部分参数、返回地址以及必要的寄存器状态。函数返回时,再把它对应的整个栈帧一起弹出。
它最大的优势就是快。CPU通常只需要维护一个指向栈顶的栈指针寄存器,创建栈帧时把栈指针移动一段距离,函数结束时再移动回来即可。它不需要在一大片内存中寻找空位,也不需要单独记录每一个局部变量应该在什么时候释放。
1 | 进入函数:移动栈指针,划出一块栈帧 |
同时栈上的数据一般会比较集中,刚刚访问的数据大概率马上还会再次访问,这种连续和局部的内存访问方式对CPU缓存非常友好。所以栈不仅分配和回收简单,实际访问速度通常也很好。
当然它的限制也正是来源于此。栈上的数据需要适应函数调用这种严格的后进先出关系,而且编译器通常需要提前知道栈帧大概要占用多少空间。如果一个数据的大小运行时才知道,或者函数结束后它还需要继续存在,就不适合单纯地跟随当前栈帧一起消失。
为什么还需要堆
假如用户输入了一段字符串,我们事先根本不知道他会输入几个字;又或者创建了一份数据,它需要跨越多个函数继续被使用,甚至要一直活到程序很后面。这时严格跟随函数进出而创建和销毁的栈就不够灵活了,于是就需要堆。
堆可以理解为进程拥有的一大片可动态管理的内存区域。程序可以在运行时申请一块指定大小的空间,并通过指针找到它;等确定不再需要时,再把这块空间交还给内存分配器。
1 | let name = String::from("XBXyftx"); |
这里的String本身通常还是由当前函数在栈上保存,它里面记录着指针、长度和容量;真正的字符串内容则存放在堆上。这样字符串需要变长时,就可以重新申请更大的堆空间,而不需要要求编译器提前猜出它最后会有多长。
堆的优势就是灵活:数据可以是动态大小,也可以拥有比创建它的函数更长的生命周期。但代价也很明显,分配器需要寻找合适的空闲区域、记录哪些内存正在使用,还要处理释放和重复利用,因而通常比单纯移动栈指针复杂。堆上的数据也可能分散在不同位置,对CPU缓存没有连续的栈数据那么友好。
这也终于能和Rust的所有权联系起来了。栈帧退出时可以整块回收,管理起来相对简单;但堆上的内存不能仅凭“某个函数结束了”就直接判断是否还能使用。如果忘记释放就会内存泄漏,提前释放会产生悬垂指针,释放两次则可能直接破坏内存。因此Rust用所有权、借用和生命周期在编译期间回答一个关键问题:这块数据现在归谁负责,它还能被谁使用,又应该在什么时候释放。
不过所有权并不只作用于堆数据,栈上的值同样拥有所有权。只是像String、Vec这种持有堆内存的类型,在移动所有权时通常只是把栈上的指针、长度和容量等管理信息移动给新变量,并不会把堆里的所有内容重新复制一遍。最后的所有者离开作用域时,Rust才会调用drop释放它所管理的堆内存。
操作系统在其中做了什么
再往底层挖的话,进程看到的通常并不是物理内存条的真实地址,而是操作系统为它建立的一套虚拟地址空间。程序使用虚拟地址访问内存,CPU中的内存管理单元(MMU)再根据操作系统维护的页表,把虚拟地址翻译到实际的物理内存页。
一个进程的虚拟地址空间也并不只有堆和栈,通常还会包括:
1 | ┌──────────────────────────────┐ |
另外CPU内部还有寄存器和多级缓存,它们甚至比主内存更靠近执行单元。所以底层当然不只有堆和栈,只是学习变量、函数和所有权时,堆与栈正好是最直接相关的两块区域,教材才会反复强调它们。
线程启动时,操作系统或运行时通常会为它预留一段栈的虚拟地址空间,并设置保护页。栈持续增长到越过边界时,就可能触发栈溢出。每个线程通常拥有自己的调用栈,因此不同线程能够同时保持各自的函数调用状态。
堆则通常由进程中的内存分配器负责日常管理。像Rust的Box、String和Vec需要动态内存时,会先向分配器申请;分配器手中的空间不够时,才会再通过操作系统提供的机制申请更多虚拟内存页。释放时也不一定立刻把物理内存归还给操作系统,分配器可能先把它留着,等待下一次分配继续复用。
所以从CPU到操作系统再到Rust,大致可以这样串起来:
1 | CPU用栈指针高效维护函数调用 |
那看来我之前产生“底层只有堆和栈”的感觉,实际上只是因为当前正在学习函数调用和所有权,这两个概念恰好会频繁地跨越栈与堆。其他数据结构并没有消失,它们只是建立在这些内存区域之上;堆和栈回答数据放在哪里、活多久、怎么回收,数组、链表和树回答数据之间按照什么关系组织以及如何访问。两个层面的概念终于对上了。
深浅拷贝
1 | let s1 = String::from("hello"); |
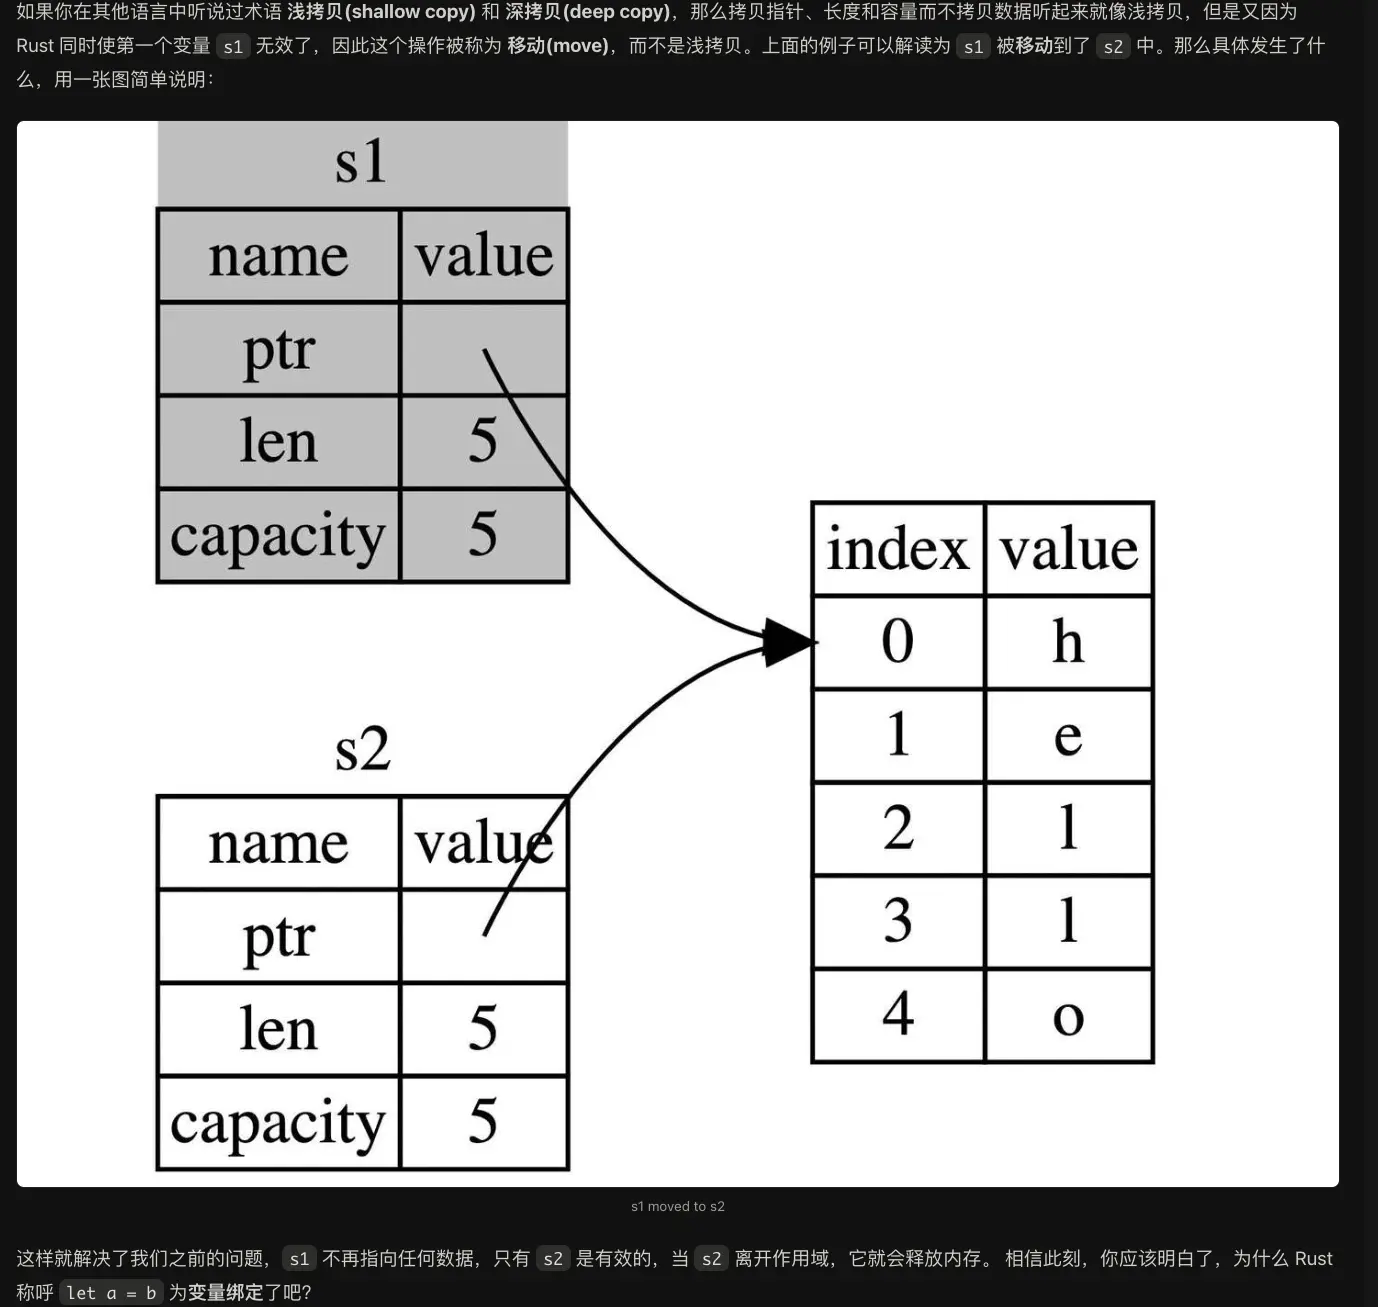
- Rust 中每一个值都被一个变量所拥有,该变量被称为值的所有者
- 一个值同时只能被一个变量所拥有,或者说一个值只能拥有一个所有者
- 当所有者(变量)离开作用域范围时,这个值将被丢弃(drop)
但是在下面这段代码中又有些不一样
1 | fn main() { |
这里之所以和前面的String不一样,是因为x的类型并不是String,而是一个字符串切片引用&str。换句话说,x并不真正拥有"hello, world"这段字符串,它只是保存了这段字符串所在的地址以及字符串的长度。
而这里的"hello, world"又是一个字符串字面量,它在程序编译时就已经被写进了静态只读数据区域,会一直存活到整个程序结束,所以它实际上拥有一个'static生命周期。
1 | x: &str |
接下来执行let y = x;时,看起来像是把x赋值给了y,但这里并没有像String一样发生所有权转移。因为&str本质上只是一个引用,而且共享引用实现了Copy,所以Rust会直接把x中保存的地址和长度复制一份交给y。
1 | x ──┐ |
所以此时x和y各自拥有一份独立的引用,只不过这两个引用都指向了同一段字符串。也正是因为复制的只是引用而不是真正的字符串内容,所以x并不会失效,后面的println!自然也就可以同时使用x和y。
这其实也并没有违反“一个值只能拥有一个所有者”的规则,因为x和y拥有的是两份不同的引用值,它们谁都不拥有背后真正的字符串。简单点来说就是:
1 | String:我拥有这段堆内存,赋值时通常会移动所有权 |
原来Rust限制的是同一个值的所有权,并不是不允许多个不可变引用同时观察同一个值。这样看来,let y = x;到底是移动还是复制,还是得看x具体是什么类型,不能只看赋值语句长得一不一样。
所有权对函数参数以及返回值的影响
这块我简单看了一下,我的编程经验告诉我这块如果是手写或是能力不太行的AI写,很容易就会出错。
我还是先搬运一下圣经中讲解的案例。
1 | fn main() { |
1 | fn main() { |
这两段原文的讲解我认为并不够细所以我们还是来展开看一下。
先看第一段,这里其实同时展示了两种完全不同的传参方式:String发生的是所有权转移,而i32发生的则是按值复制。虽然在代码中它们都只是向函数的括号里传入了一个变量,但底层发生的事情并不一样。
String 传入函数:转移的是管理权,堆数据并没有复制let s = String::from("hello");内容:"hello"
此时 s 是 H1 的唯一所有者,负责保证这块堆内存最终被释放。
takes_ownership(s);仍然是同一个 "hello"
指针、长度和容量被移动给形参,H1 没搬家也没复制;原来的 s 被编译器判定为失效。
println!("{}", some_string);通过所有者读取 "hello"
函数内部可以正常使用 some_string,因为管理权已经完整地转移到了它手里。
} // some_string drop只释放一次,不会轮到 s 再释放
形参离开作用域,Rust调用 drop。回到 main 后,s依旧不可用。
i32数据固定且很小,值直接存放在变量中。
函数拿到一份独立的5,原来的x仍然有效;这里没有堆内存需要转移或释放。
这样看第一段就很清楚了。takes_ownership(s)不是把堆上的"hello"完整复制进函数,而是把String中用于管理堆内存的指针、长度和容量交给了some_string。为了避免main中的s和函数里的some_string最后都去释放同一个地址,Rust在移动发生之后就直接让s失效,只留下一个合法的所有者。
makes_copy(x)则完全不是这套流程。i32实现了Copy,传参时会直接复制一份数值5给some_integer,所以函数内外各有一份互不干扰的5。函数结束时some_integer消失,main中的x依旧可以继续使用。
再来看第二段,它展示的不是“所有权被函数吃掉”,而是所有权可以顺着返回值继续流动。函数的边界并不会阻止所有权转移,只要把值返回出去,管理权就能交给调用者。
String:所有者可以换名字,堆内存继续存活H2 当前所有者
但不释放 H2
成为新所有者
H2 · "hello"some_string作为末尾表达式被返回时,它不会在函数结束处执行drop,因为所有权已经移动给了s1。
不再拥有 H3
临时拥有 H3
最终拥有 H3
H3 · "hello"H3的所有权经历s2 → a_string → s3两次移动,字符串内容并没有因此复制两次。
drop。第一条路线中,some_string虽然是gives_ownership函数里的局部变量,但它在函数结束前被作为返回值移动了出去。因此函数栈帧消失时,some_string这个变量名确实不存在了,可它管理的堆内存并没有被释放,而是继续由接住返回值的s1负责。
第二条路线就更像一次所有权接力。s2先把所有权交给形参a_string,所以s2立即失效;随后a_string又通过返回值把所有权交给s3,因此它也不会在函数结束时释放那块堆内存。等到main结束,最终所有者s3才会负责释放它。
这里需要注意,图中说的“移动”是在解释Rust的语义规则,并不等于机器执行时一定要把指针、长度和容量这三个机器字来回复制很多次。编译器知道返回值最终要落到哪里后,可能直接在调用者准备好的返回位置中构造结果,或者通过寄存器传递并进行优化。但无论最终机器代码怎么优化,Rust在类型系统中保证的事实始终不变:任意时刻只有一个变量负责那块堆内存,旧的绑定在移动之后不能继续使用,最终也只会有一个所有者执行drop。
那这样看来,函数参数和返回值都只是所有权流转的入口。真正需要盯住的不是变量叫什么,也不是跨过了几个函数,而是每执行完一行代码之后,当前到底是谁拥有那块资源。只要这个问题能够回答出来,什么时候变量会失效、什么时候堆内存会释放,也就都能顺着推出来了。
复合类型
String
1 | fn main() { |
套用上面的理论其实我们能很明显的看出这段代码的问题。my_name我们并没有真正意义上的去拥有"Pascal"这个字符串,我们真正创建的变量类型其实是:&str一个引用
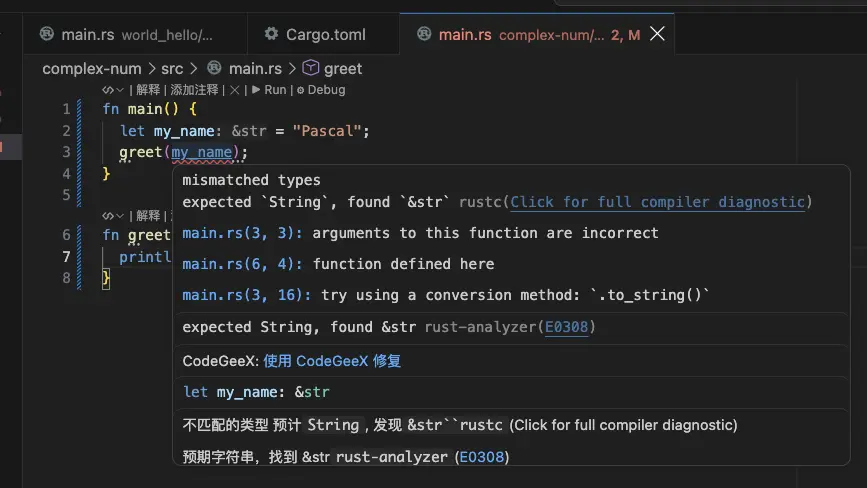
这个特性可能对于完全没学过编程的小白来说是可以接受的,但对于其他语言的程序员来说肌肉记忆这一块还是需要进行一下对抗的。
圣经后面对于切片的部分解释也很有意思,但还有一个让我感觉可以理解,但也确实阴到极点的存在:
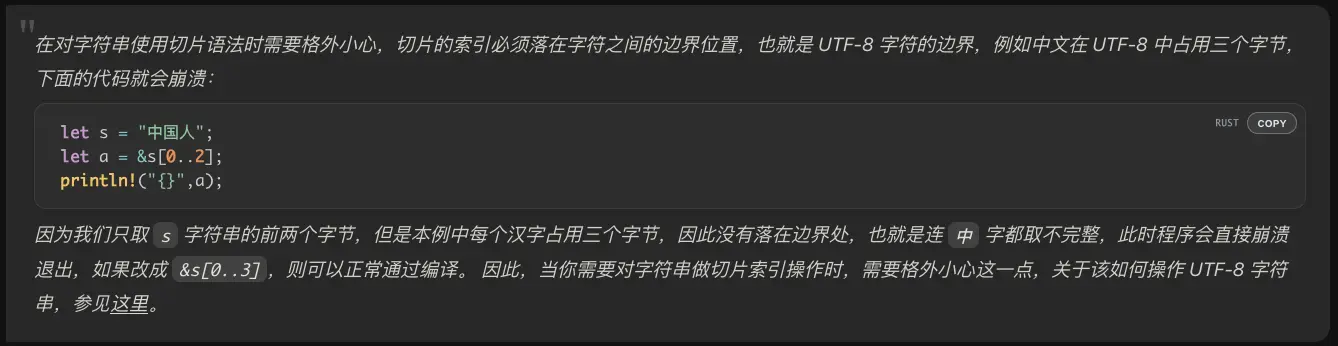
哇中文和英文的字节数不一样这一块。那对于实际应用场景我感觉也会有这个问题啊。
这一块确实是实际项目里最容易踩坑的地方之一。Rust里的String和&str都是用UTF-8编码的,而UTF-8是一种变长编码:英文、数字、常见标点这些ASCII字符只占1个字节,一个中文字符却要占3个字节,emoji更是要占4个。
所以String的.len()并不是“有多少个字符”,而是“一共有多少个字节”:
1 | let s = String::from("Hello 你好"); |
"Hello 你好"看起来只有8个可见字符,但字节数却有12,多出来的4个字节全被两个汉字吃掉了。
这就直接引出实际场景中的核心问题:我们到底想按“字符”来限制,还是按“字节”来限制?
比如注册时限制昵称最多20个字符。如果直接判断s.len() > 20,英文用户可能很宽松,但中文用户明明只输了10个字,.len()就已经30了,直接被误杀。这种“用户肉眼能看到的数量”应该按字符算:
1 | if nickname.chars().count() > 20 { |
反过来,如果是“这条消息传到服务端不能超过多少字节”,或者“数据库字段实际占用不能超过多少”,那就反而要看.len(),因为存储、传输、序列化消耗的确实是字节。很多系统的长度上限是按字节算的,同一个上限,英文能放64个字符,中文可能连一半都放不下。
还有一个更阴的坑就是切片。Rust字符串的下标其实是字节位置,如果切到了某个汉字的中间,直接panic:
1 | let s = "你好,世界"; |
真实业务里最常见的场景是“标题过长要截断显示”。如果直接按字节数硬切,非常容易panic,所以一般要先拿到每个字符的起始字节位置,再找安全边界:
1 | fn truncate(text: &str, max_chars: usize) -> &str { |
这段代码可以先用一句大白话概括:保留字符串前max_chars个字符,然后把后面的内容丢掉。
如果用TypeScript来写,很多人第一反应可能是这样:
1 | function truncate(text: string, maxChars: number): string { |
这里的思路很直观:
Array.from(text)先把字符串拆成一个个元素;.slice(0, 6)取下标0到5的前6个元素;.join('')再把它们拼回字符串。
Rust也要做同样的事情,只是它对字符串的处理更严格。这里特意使用Array.from,而不是直接使用text.slice(0, 6):因为JavaScript字符串底层按UTF-16保存,直接slice遇到emoji时也可能把一个符号从中间切开。Array.from会先按Unicode字符拆开,再进行截取。Rust里的&str则是一段有效的UTF-8字节,字符串切片使用的下标其实是字节位置,不是“第几个字符”。所以Rust不能直接写“取前6个字符”,而是必须先找到一个安全的字节位置,再从那里切下去。
先理解usize:它就是Rust版的“下标和长度专用整数”
TypeScript里只有一个比较宽泛的number类型。你可以把它拿来表示价格、分数,也可以拿来表示数组下标:
1 | const price: number = 19.9; |
但Rust会把这些用途分得更细。usize是Rust专门用来表示“长度、下标、数量”的无符号整数类型。所谓“无符号”,用大白话说就是:它不能表示负数。
1 | let a: usize = 10; // 合法 |
为什么长度和下标适合用usize?因为数组长度不可能是负数,下标也不应该是负数。字符串的.len()、Vec的长度、数组下标相关的操作,基本都会使用usize。
所以函数参数写成:
1 | fn truncate(text: &str, max_chars: usize) -> &str |
就是在告诉编译器:max_chars代表要保留多少个字符,它只能是一个非负整数。如果有人写truncate(title, -1),错误会在编译阶段被发现,不会等程序运行起来之后才出问题。
这里不需要一开始就被“64位系统是64位、32位系统是32位”吓到。可以先把usize记成一句话:凡是表示数组下标、字符串长度、元素个数的地方,Rust经常使用usize。它的底层大小会跟着当前机器的寻址能力变化,所以才叫usize,可以理解成“适合当前机器使用的size类型”。
再理解nth:它不是“取第n个”,而是“跳过n个后再取一个”
nth是迭代器的方法。迭代器可以简单理解成一条“从前往后取元素”的流水线。nth(n)的规则是:先跳过前n个元素,再把下一个元素交给你。
因此,下标从0开始时:
1 | let s = "abc"; |
这和TypeScript里的数组下标有一点像,但写法不一样:
1 | const chars = ['a', 'b', 'c']; |
如果把Rust的nth(1)翻译成大白话,它不是“取下标为1的东西”,而是“从当前位置跳过1个,再取下一个”。恰好因为迭代器一开始位于第0个元素之前,所以第一次调用时,它看起来才和数组下标的效果一样。
另外,迭代器是会被“消费”的。也就是说,前面跳过的元素不会再回来:
1 | let mut iter = "abc".chars(); |
不过上面truncate里的text.char_indices().nth(max_chars)只使用了一次迭代器,所以不用担心“消费”会影响其他地方。
char_indices()到底返回了什么?
char_indices()可以理解成“把字符串里的每个字符和它的字节起点一起列出来”。它产生的每个元素都是一个二元组:
1 | (这个字符从第几个字节开始, 这个字符本身) |
例如字符串"Rust学习"大致会得到:
1 | (0, 'R') |
前4个英文字符各占1个字节,所以学从第4个字节开始;学是中文字符,在UTF-8中占3个字节,因此下一个字符习从第7个字节开始。
现在再看这句:
1 | text.char_indices().nth(max_chars) |
假设max_chars是6,它的意思不是“找到第6个字符”,而是:
char_indices()按顺序产生字符和字节位置;nth(6)跳过前6个字符;- 返回第7个字符以及第7个字符的起始字节位置。
为什么要找第7个字符?因为第7个字符的起点,刚好就是前6个字符的终点。我们不需要第7个字符本身,只需要它的起始位置,就可以从那里安全地切开。
这里的match也可以先把它理解成Rust版的“根据结果分情况处理”。TypeScript里你可能会写成这样:
1 | const result = findIndex(); |
Rust不直接用undefined表示“可能有值、也可能没有值”,而是用Option把这件事写得很明确:有值就是Some(...),没值就是None。match会要求你把这两种情况都处理掉,因此不容易漏掉“字符串不够长”这个分支。
所以:
1 | Some((idx, _)) => &text[..idx] |
可以翻译成:
Some((idx, _)):确实找到了第7个字符,把它的字节位置取名为idx;idx:就是前6个字符结束的地方;_:第7个字符是什么并不重要,所以不保存它;..idx:表示从字符串开头,一直到idx之前;&text[..idx]:借用这一段字符串,正好得到前6个完整字符。这里的&不是复制字符串,而是借一段原字符串出来看。
如果字符串总共还不到7个字符,nth(6)就找不到目标,会得到None。这说明字符串本来就没有超过6个字符,此时直接返回原字符串即可:
1 | None => text |
把整个函数翻译成更接近人话的伪代码,就是:
1 | 找到“第 max_chars + 1 个字符”的起始字节位置 |
用例子完整走一遍
1 | 字符串:Rust学习笔记:所有权与借用 |
调用:
1 | truncate(title, 6) |
max_chars是6,所以代码执行nth(6):
- 跳过下标为
0到5的6个字符:R、u、s、t、学、习; - 找到下标为
6的第7个字符:笔; - 发现
笔从第10个字节开始; - 从第10个字节切开:
&title[..10]; - 得到
Rust学习。
这里的10不是“第10个字符”,而是“第10个字节”。因为它正好是笔这个完整字符的起点,所以从这里切一定安全,不会把任何一个汉字切成半个。
如果用TypeScript来类比,Rust实际上是在手动完成Array.from(title).slice(0, 6).join('')背后的安全工作:TypeScript先把字符串拆成元素再截取;Rust为了保证UTF-8不被破坏,先找到第6个字符后面的字节边界,再进行切片。
顺带一提,chars()数的是Unicode标量值,像emoji这种由多个码点组合出来的“符号”会更复杂一点,但日常中英混排用不上,先不展开。
所以处理中英混排的字符串,第一步不是想着用什么语法糖,而是先想清楚需求按什么单位算:显示、输入限制、截断通常按字符数;存储、传输、加密、序列化通常按字节数。想明白这一点,再用chars()、bytes()、char_indices()这些工具去实现,就基本不会出错了。

全站换装 Windows XP 复古窗口!

今日更新:
- 首页轮播与瀑布流卡片换上 XP 平面窗口:纯蓝标题栏、四色徽标、装饰按钮与硬阴影;鼠标悬浮卡片时窗口会像被“激活”一样点亮,触屏下则常亮、点按有下沉反馈。
- 侧边栏的公告、最新文章、标签、归档、站点信息与文章目录全部改为深色 XP 窗口;作者卡保留原有的渐变蒙版与背景图,一动不动。
- 文章正文换为统一的深色窗口配色,note 提示块、折叠块、按钮、选项卡、时间轴等标签插件全部完成适配,长时间阅读更护眼。
- 修复轮播偶尔空白的问题:慢网或脚本加载失败时会先静态展示第一篇精选,恢复后自动开始轮播;目录高亮统一为 XP 蓝,部分复习文章浅色表格的文字也补齐了对比度。
愿这扇复古的小窗口,能让你在翻文章时多一点会心一笑。✨
今日更新:
文章目录学会了折叠!
今日更新:
- 文章目录新增折叠分组,hideToggle 折叠块内的标题会收纳进一个以块标题命名的可折叠目录项,长文目录更清爽。
- 点击折叠组内的目录链接会自动展开对应的折叠内容块并滚动到位,不再出现“跳转了却看不到内容”的情况。
- 阅读滚动到折叠区域时,目录中的折叠组会自动展开并高亮当前小节;折叠箭头也已对齐文字中线。
愿长文的每一段内容,都能在你需要时恰好展开。✨
今日更新:
首页星空与文章阅读可读性再次升级!
今日更新:
- 首页瀑布流卡片的信息区改为直接透出全屏动态星空,保留六组深色玻璃配色差异,让每张卡片更有层次,同时不新增 Canvas、粒子或动画预算。
- 背景与顶部封面星空统一调整为更明亮、更大一些的冷蓝白星光,流星和尾迹同步增强可见度,原有 30fps、粒子数量与性能边界保持不变。
- 移除文章卡片标题、摘要后方的大范围暗色雾层和标签暗色底,让星光自然透入;标题、日期、标签和摘要继续保留轻量投影以确保清晰。
- 修复 Butterfly 自带 `{% note flat %}` 提示区块的文字颜色,浅色提示背景内统一使用近黑色文字,信息、警告和危险提示均更易阅读。
愿星光更明亮,文字更清晰,每一次阅读都能保持舒适。✨
本次更新:
首页与文章阅读体验再次升级!
本次更新:
- 首页瀑布流悬浮光晕改为更柔和的连续水波,半径缩小约一半,并统一为青色、绿色与冷白色相间。
- 文章主内容区切换为透亮的黑深蓝夜空磨砂背景,淡青色星点和环境光可以透出背景图。
- 正文、标题、链接与弱文本同步调整对比度,阅读模式、代码块、引用块和图片样式保持兼容。
愿每一次浏览,都能在清晰与氛围之间找到刚刚好的平衡。✨
本次更新:
Markdown 工作台完成深度升级!
本次更新:
- 编辑器升级为接近 VS Code 的本地优先工作台,支持 Markdown 高亮、行号、搜索替换、命令面板、自动保存、导入导出与安全预览。
- 修复编辑区背景缺失、桌面分栏错位、预览越界和全屏底部黑区;全屏布局现在会完整填充视口。
- 桌面进入全屏后默认左右分屏,并在顶部提供更醒目的“源码 / 分屏 / 预览”切换按钮;移动端继续使用单面板模式。
- 预览始终经过安全净化,脚本、事件属性和危险链接不会执行;草稿只保存在当前浏览器,不上传服务器。
愿每一次敲下键盘,都能更顺畅地把想法写成作品。✨
本次更新:
昨日重现,重新浮现!
本次更新:
- “昨日重现”照片墙完成重构,照片会随机播放,向上或向下滚动都能在视野中梦幻浮现;离开视野后隐入,再次经过时重新出现。
- 图片改为真正的近视口懒加载,只有接近视野才会开始请求,并通过统一队列限制并发,尽量减少小带宽服务器的压力。
- 重建图片清单与布局系统,提前根据图片尺寸保留位置,减少滚动时的跳动;“重新随机排列”按钮也不再把浏览器 HTTP 缓存误称为可清除的图片缓存。
- 新增可配置的 WebP 压缩工具,可按质量、最长边和压缩方式优化图库;本次仅完成 dry-run 检查,未直接修改照片原文件。
愿每一段旧时光,都能在下一次滚动时温柔地浮现出来。✨
本次更新:
公告历史时间轴已上线!
本次更新:
- 公告栏已支持纵向时间轴,可继续查看每一版历史公告;
- 每一版公告都会标记发布时间,历史内容可以通过 Git 记录追溯恢复;
- 新公告统一维护在 source/_data/announcements.yml,后续新增只需在文件顶部添加一条记录。
感谢你的测试与反馈,欢迎继续探索这个会不断成长的小站!✨
近期优化已完成:
欢迎来到神秘的小破站!
近期优化已完成:
- 首页瀑布流升级为按需响应式 3/2/1 列布局,移除高频轮询与冗余调试;
- 清理失效资源请求,修正本地图片兜底与历史路径;
- 文章图片保留原生懒加载,仅近视口显示轻量占位效果;
- 目录跳转会在图片晚到时自动校正标题位置,桌面与移动端均已适配。
愿你在这里阅读顺畅、探索愉快,收获每一份灵感!✨
近期优化已完成:
欢迎来到这里!
近期优化已完成:
- 首页瀑布流升级为按需响应式 3/2/1 列布局,移除高频轮询与冗余调试;
- 清理失效资源请求,修正本地图片兜底与历史路径;
- 文章图片保留原生懒加载,仅近视口显示轻量占位效果;
- 目录跳转会在图片晚到时自动校正标题位置,桌面与移动端均已适配。
愿你在这里阅读顺畅、探索愉快,收获每一份灵感!✨
欢迎来到这里!
欢迎来到这里!
本站近期完成首页瀑布流性能优化:移除高频轮询和冗余调试逻辑,改为响应式 3/2/1 列布局,并按需重新排版。
希望能带来更稳定、轻快的浏览体验!
welcome!
welcome!
近期进行了不少的优化,也不知道大家感受出来没,加载速度啊、目录跳转稳定性啊巴拉巴拉的。
总之祝大家2026新春快乐!!!
(也是开始上班了呢]
welcome!
welcome!
近期进行了不少的优化,也不知道大家感受出来没,加载速度啊、目录跳转稳定性啊巴拉巴拉的。
总之祝大家2026新春快乐!!!
welcome!
welcome!
welcome!
welcome!
热烈庆祝鸿蒙五终端数量突破两千万!!!
热烈庆祝鸿蒙五终端数量突破两千万!!!
鸿蒙生态,星河璀璨!
鸿蒙生态,星河璀璨!
本站由于服务器带宽有限,设置了文章图片懒加载,滚动停止后才会开始加载图片,遇到加载中的图片请静止等待
本站由于服务器带宽有限,设置了文章图片懒加载,滚动停止后才会开始加载图片,遇到加载中的图片请静止等待
笑死还说假期填坑呢,倒是给自己新开了个无底巨坑
笑死还说假期填坑呢,倒是给自己新开了个无底巨坑
最近也是给自己挖了挺多坑还没填上的等暑假慢慢填吧,争取暑假把自己想写的都写上。
最近也是给自己挖了挺多坑还没填上的等暑假慢慢填吧,争取暑假把自己想写的都写上。
主页大翻新啦!!!快来看快开看啊!!!
主页大翻新啦!!!快来看快开看啊!!!
ICP备案完成!xbxyftx.top正式恢复运营!!!
ICP备案完成!xbxyftx.top正式恢复运营!!!
25年的计划开始执行了吗?
25年的计划开始执行了吗?
This is my Blog
This is my Blog